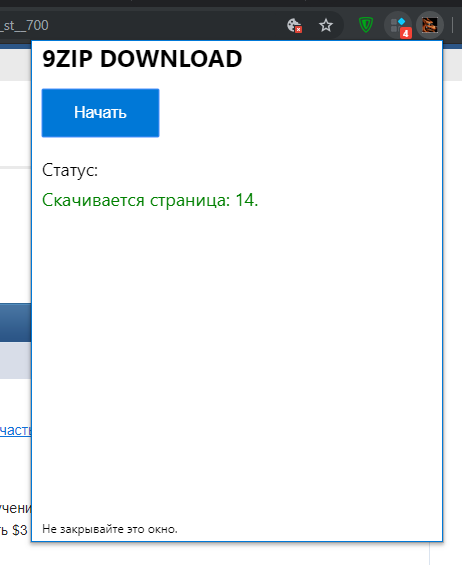
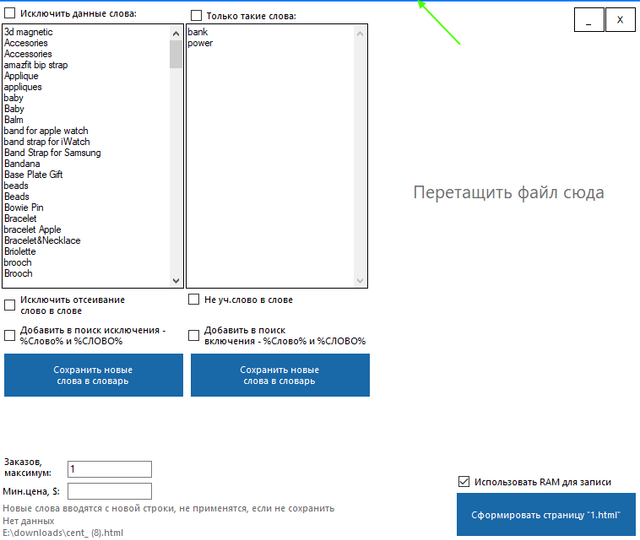
2)Из самой программы(информация внизу, список будет более релевантным)*
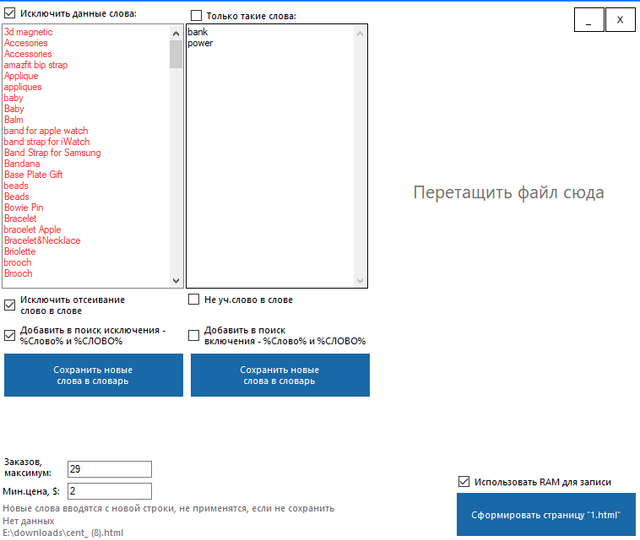
Затем эту страницу нужно перетащить в окно программы, после чего выбрать нужные фильтры и нажать на кнопку -
"Сформировать страницу", после чего начнется анализ спец.страницы и запись в файл "1.html"(будет находится там же,
где и .exe файл программы).
Если не используется RAM для записи,"1.html" можно открыть в любой момент, если же для записи используется RAM (чекбокс - "Использовать RAM для записи") - то содержание страницы запишется только после анализа всех данных.
Если ожидается множество результатов(например >=500), то рекомендуется использовать RAM.Если результатов слишком много и мало оперативной памяти, то они могут переполнить память, в таком случае необходимо использовать только запись сразу в файл, что будет гораздо медленнее для множества результатов.
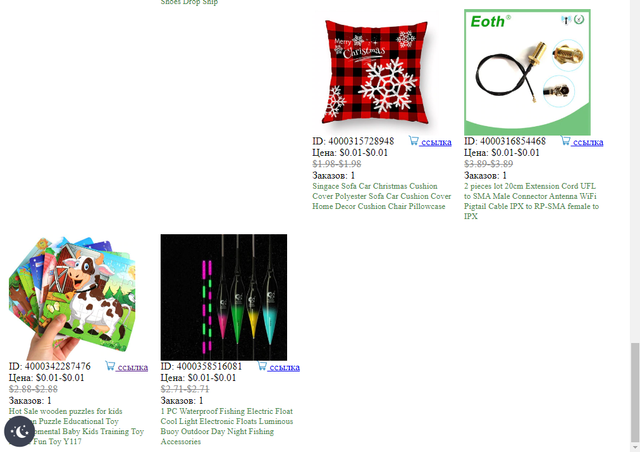
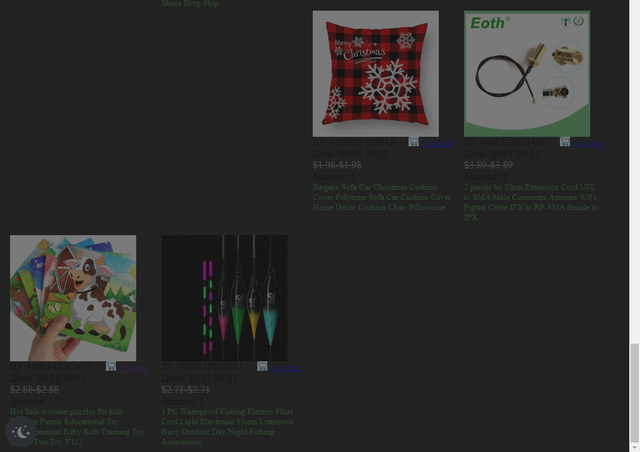
По окончании анализа появится окно, которое содержит количество пройденного времени для анализа и опции выбора - открыть файл сразу в браузере, открыть папку, содержащую файл "1.html",либо выйти из программы(иногда это окно может перекрыть сама программа, необходимо сдвинуть главное окно).Открыв в браузере файл, можно включить\отключить ночной режим,нажав на иконку луны, также будет написано количество результатов после отсеивания.
____________________________________
Выборки(всё чувствительно к регистру).
Исключения:
Исключить данные слова - исключает из результатов все вхождения данных слов.
Исключить отсеивание слово в слове - Не исключит результат, содержащий acase, если вы исключили case.
Добавить в поиск исключения %Слово% и %СЛОВО% - если исключили слово fishing, то в исключения также попадут слова
Fishing и FISHING.
Включения:
Только такие слова - добавит в страницу все вхождения, содержащие данные слова.
Не учитывать слово в слове - исключить такие результаты, как soldering при поиске solder, madagascar при поиске gas.
Добавить в поиск включения %Слово% и %СЛОВО% - будут включены результаты, содержащие Fish и FISH, при поиске fish.
Включения и исключения комбинируются.
____________________________________
Сохранить новые слова в словарь - каждый раз при добавлении нового слова в текстовое поле,
необходимо нажимать на эту кнопку, у исключения и включения она своя собственная и соответственно
находится под их полями.Если слова не сохранены - они подсвечены красным, и, если нажать на кнопку - сформировать
страницу, то эти слова не будут учитываться при поиске, так как, они не сохранены.
При каждом сохранении список слов сортируется по алфавиту в порядке возрастания.
Также слова можно добавлять вручную с новой строки - изменяя файлы bad.txt и good.txt, если программа в этот
момент запущена,ее необходимо перезапустить, для того чтобы заново считать данные файлы.
____________________________________
Заказов, максимум - добавятся результаты, только с указанным максимумом количеством заказов.
Минимальная цена,$ - минимальная цена,только при которой товар добавится в страницу, в долларах, в т.ч. и в десятых.
_____________________________________
[*Экспериментальная функция.
Чтобы ее вызвать необходимо щелкнуть на верхнюю синюю полосу.
Откроется панель с прочими функциями:
Верхнее поле - это добавления хвостов к запросу страницы с центовиками.
Поле postback - токен предыдущего запроса, если оставить пустым, формируется сам
после первого запроса.
Загрузить с ali json - грузит весь список центовиков в папку jsondata
в формате - json0.txt, json1.txt и так далее до конца, где в каждом json-файле
по 20 результатов, перед каждым последующим запросом происходит пауза со случайным временем,
максимальное время пауз - 4,3 минуты для 500 файлов.
После нажатия на эту кнопку программа замораживается, отследить прогресс - можно зайдя в папку jsondata -
все время там должны добавляться новые файлы.
По окончанию появится сообщение - "Скачаны все файлы json"(обычно их около 500).
Если сейчас нажать на ОК, то начнет формироваться страница html_from_json1.html -
программа перестанет отвечать, для формирования требуется больше времени, чем для скачивания файлов
json.
Чтобы страница тут же не начала формироваться - не надо нажимать на ОК - надо закрыть программу.
Позднее ее можно будет сформировать нажав соответствующую кнопку на панели(папка jsondata при этом не должна быть
пуста, так как страница формируется из кучи файлов json[].txt в папке jsondata).
Когда страница сформируется появится сообщение -"Html-файл из json готов.".
Img2b64 с 1.html в big_data.html - функция переводит все изображения с файла 1.html в base64, требуется
очень много памяти и время, стабильное интернет-соединение, если оно все таки-прервалось,
появится сообщение - перед тем, как нажать на ОК - необходимо восстановить интернет-соединение
и только после этого нажать - ОК - выполнение продолжится.
Ali как и Авито запрашивает три отпечатка. 1- при открытии сайта в браузере WebGL fingeprint.- прорисовка график скрытая и отправка отпечатка графической подсистемы (лечится WebGL fingeprint defender -настроек нет , как сработает ,отключаем) 2- АudioContext fingeprint при разворачивании меню входа в аккаунт ( посылат воспроизведение звука браузером нулевой громкости и считыват данные подсистемы звука , формирует хэш и получает отпечаток , лечится АudioContext fingeprint defender настроек нет , как сработает ,отключаем в управлении расширением Иначе оба defendera постоянно генерят новый хеш и у вас будет верка) Отключив их Мы застолбим два отпечатка в сессии.3- с этого момента будут запросы на Сanvas fingeprint ( лечится Сanvas fingeprint defender в режиме без обновления (ручной) Его сработку можно игнорировать, главное до захода на сайт( не путать с входом в аккаунт) сгенерировать хэш нажимая красную кнопочку , но только один раз Важно , в процессе всей сессии больше не менять хэши. Иначе верка.Можете установить все три дополнения и не отключая их прогулятся с ним по аккаунту , зайдите в профиль и там будут запросы на три отпечатка. Будет верка , зато увидите полноту процессов снятия отпечатков.